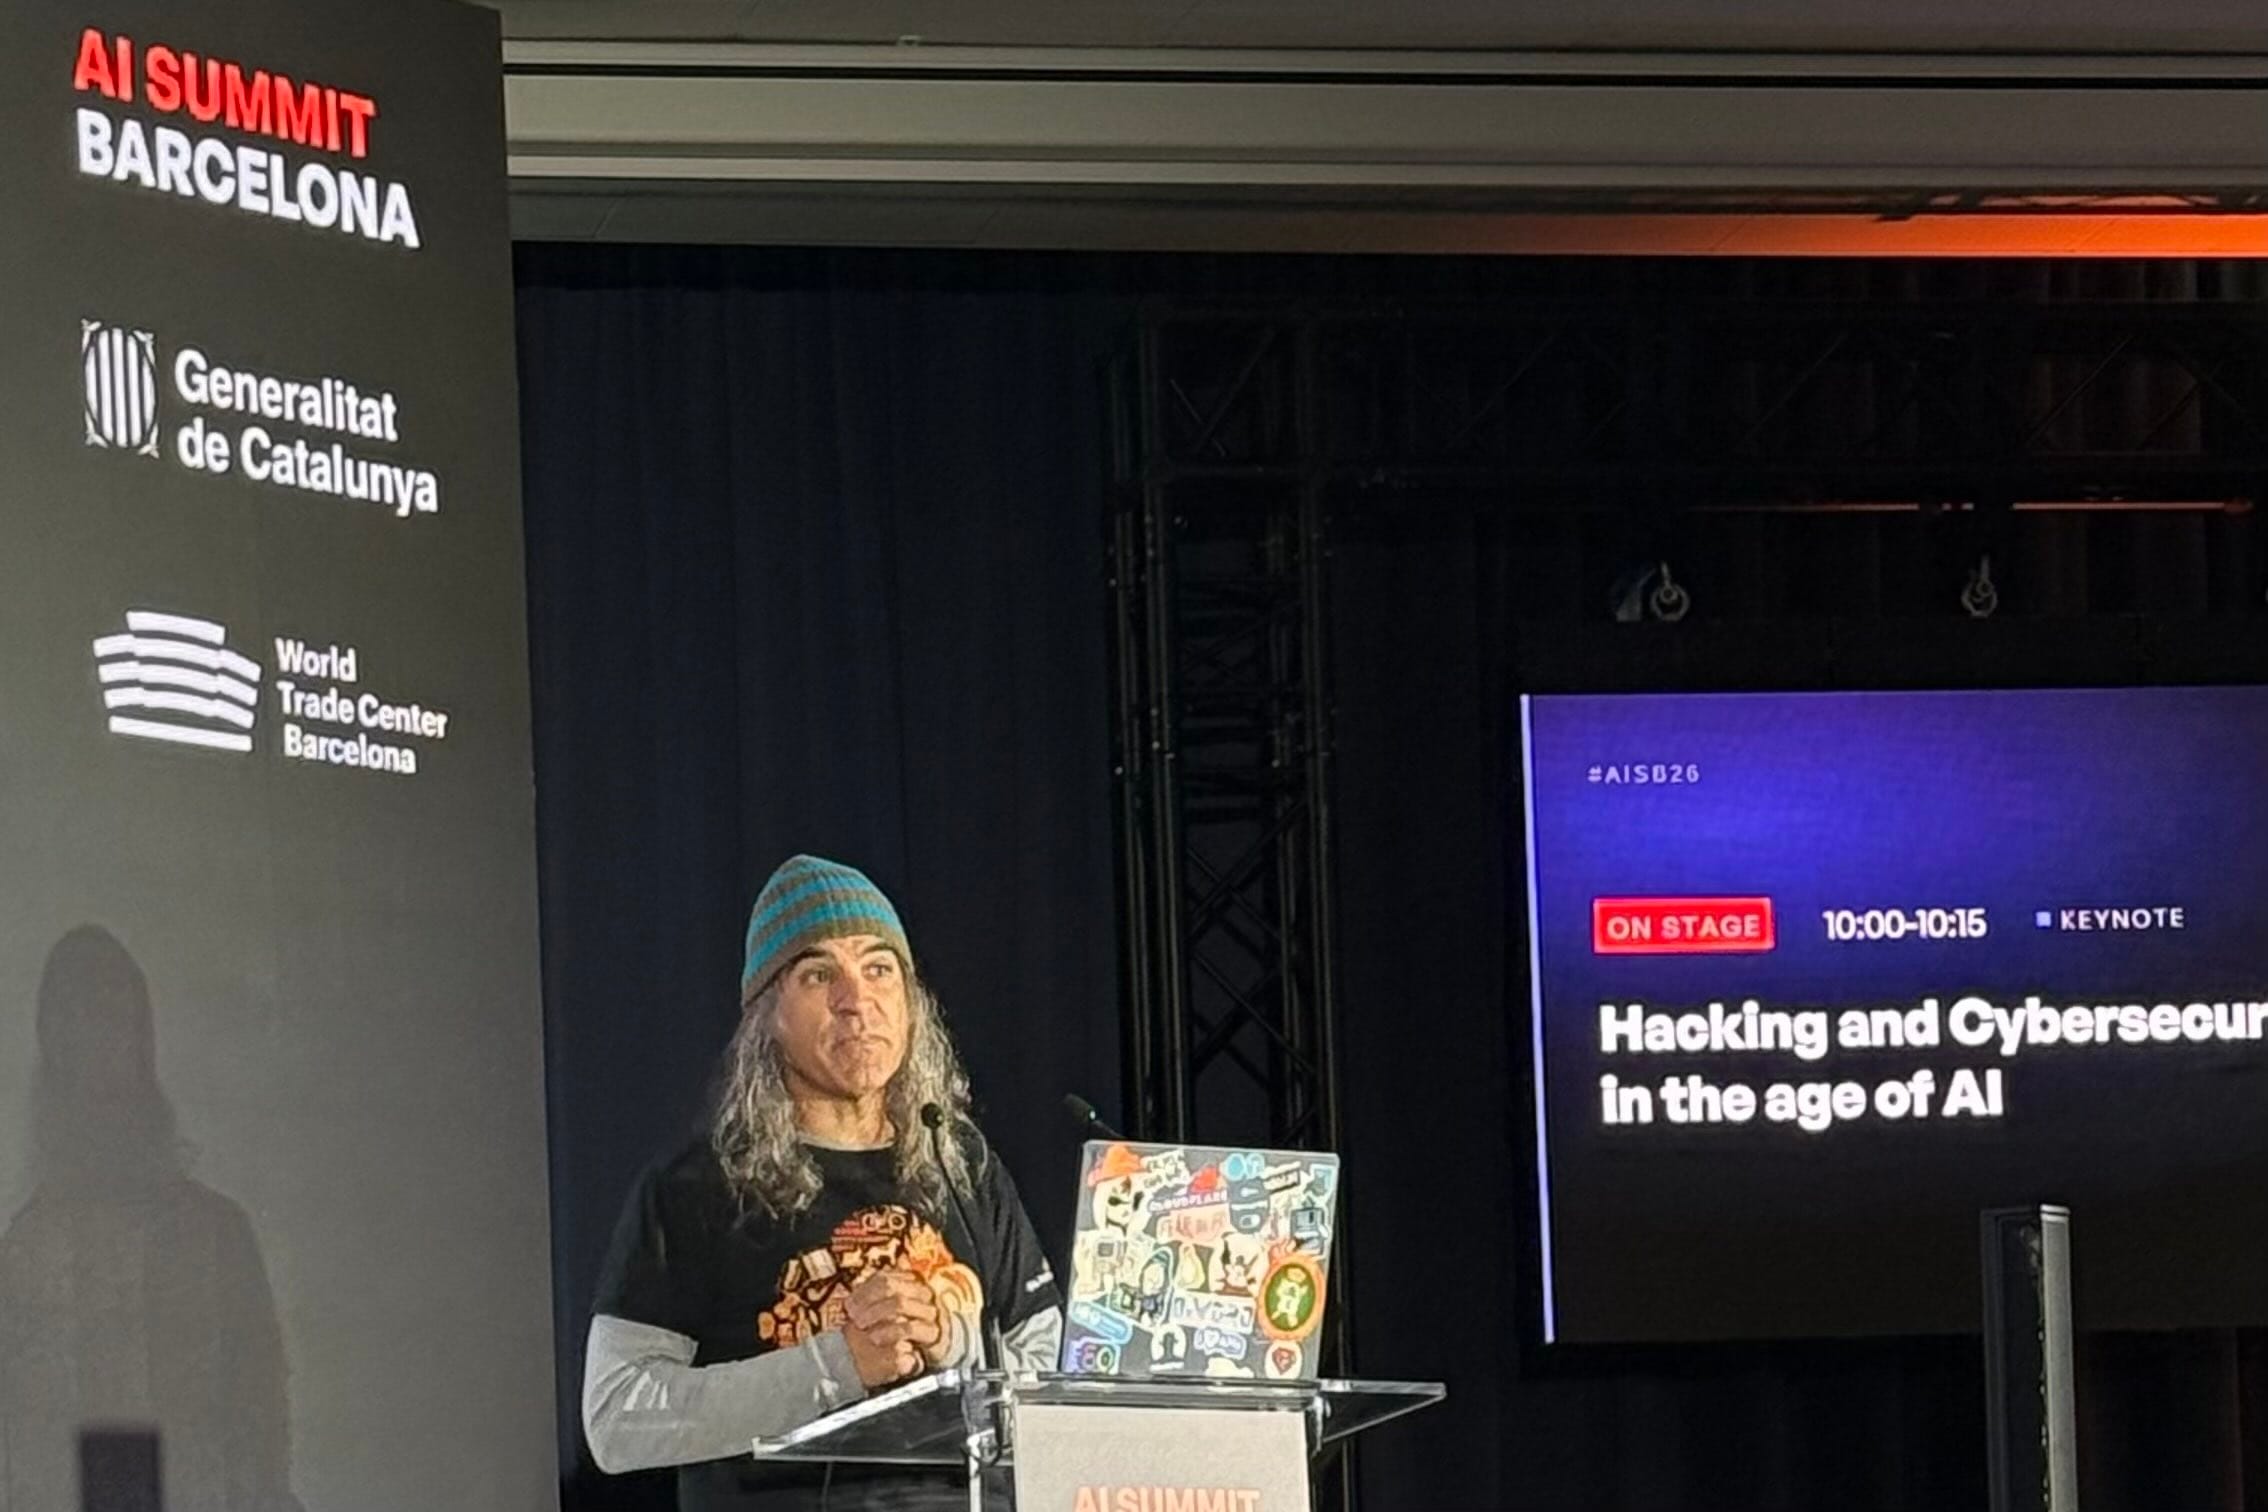
«Hello, hackers. How are you?» Mit diesen Worten begann Chema Alonso seinen Vortrag gestern am ersten Tag des AI Summit Barcelona. Das Publikum als Hacker anzusprechen, war die passende Eröffnung für eine Session über Hacking und Cybersecurity im Zeitalter von KI. Alonso hat einen Doktortitel im Bereich Cybersecurity, er ist Unternehmer, Speaker, Hacker und seit letztem Jahr VP Head of International Development bei Cloudflare. Sein Vortrag begann mit vier Minuten Cloudflare-Werbung und endete mit der Frage «And you know what is the best company for doing that?».
Die Moderation hatte den Übergang hergestellt. Direkt zuvor lief die Eröffnungskeynote über Kataloniens Milliarde für künstliche Intelligenz. Wer eine Milliarde auf etwas setze, ziehe damit auch die Aufmerksamkeit anderer auf sich. Für diesen Teil war Alonso zuständig. Seine zentrale These: Dieselbe Schicht, die KI-Agenten für produktive Arbeit brauchbar macht, hat autonomes Hacken überhaupt erst funktionieren lassen. Wer Agenten einsetzt, baut an derselben Fähigkeit mit, die Angreifer stark macht.
Inhalt
Warum Agenten am Werkzeug scheiterten
Alonso stieg mit einer eigenen Erinnerung ein. 2007 veröffentlichte er als junger Forscher ein Paper über Blind-LDAP-Injection und suchte für seinen Vortrag an der Black Hat in Amsterdam von Hand nach verwundbaren Produkten. Zeile für Zeile. 2025 gab er denselben Code einem Reasoning-Modell und erhielt in einem Durchgang mehr Schwachstellen, als er damals selbst gefunden hatte.
Das allein wäre nur eine Anekdote über bessere Werkzeuge. Interessant wurde es beim nächsten Schritt. Forschende versuchten schon 2024, Sprachmodelle ganze Netzwerke selbstständig angreifen zu lassen. Es funktionierte ansatzweise, scheiterte aber verlässlich an derselben Stelle: Die Modelle kamen mit den Werkzeugen nicht zurecht. Sie verhedderten sich in API-Parametern und Kommandozeilenaufrufen. Nicht die Strategie fehlte, sondern die Fähigkeit, sie in korrekte Befehle zu übersetzen.
Incalmo: die Schicht, die alles veränderte
Genau dort setzt das Paper an, auf das sich Alonso bezog. Ein Team der Carnegie Mellon University um Brian Singer und Keane Lucas baute ein System namens Incalmo, eine Zwischenschicht zwischen Modell und Angriffswerkzeug. Das Modell muss keine Befehle mehr formulieren. Es sagt, was es will: Netzwerk scannen, Host infizieren, sich seitlich bewegen, Daten abziehen. Die Übersetzung in konkrete Aufrufe übernimmt die Schicht.
Die Wirkung dieser Umstellung ist in den Zahlen des Papers deutlicher, als Alonso sie auf der Bühne wiedergab. Getestet wurde an 40 nachgebauten Netzwerken mit 22 bis 50 Rechnern. Etablierte Systeme wie PentestGPT erreichten ihr Ziel in 3 von 40 Umgebungen. Mit Incalmo waren es 37 von 40. Ein erfolgreicher Angriff dauerte zwischen 12 und 54 Minuten und kostete weniger als 12 Schweizer Franken an Modellzugriffen.
Die Modelle waren also nie das Problem. Sie hatten bloss kein brauchbares Interface zur Welt. Sobald jemand eines baute, kippte das Ergebnis von fast nie zu fast immer.
Und heute heisst diese Schicht MCP
An dieser Stelle machte Alonso den Sprung, der seinen Vortrag trug. Das Paper stammt aus der Zeit vor der breiten Verfügbarkeit des Model Context Protocol. Incalmo war eine Forschungskonstruktion, gebaut für einen einzigen Zweck. Heute ist diese Abstraktionsschicht Standardinfrastruktur. MCP macht genau das, was Incalmo tat: Es erspart dem Modell die Details des Werkzeugs und nimmt Absichten entgegen.
Wie weit das inzwischen reicht, zeigt der Blick auf eine einzelne WordPress-Installation. Dort stehen über MCP oft schon dutzende Werkzeuge bereit, aus dem Core, aus Rank Math und aus Adaptern, meist ohne dass es jemand bewusst eingerichtet hätte. Das ist keine Kritik am Protokoll, sondern eine Feststellung über seine Natur. Eine Schicht, die Absichten in Werkzeugaufrufe übersetzt, ist gegenüber dem Zweck neutral. Wer sie baut, damit ein Agent Rechnungen erfasst oder eine Website pflegt, baut dieselbe Fähigkeit, die im Forschungsaufbau 37 von 40 Netzwerken kompromittierte. Der Unterschied liegt nicht in der Technik, sondern in der Absicht dessen, der sie ansteuert.
Für Unternehmen, die gerade MCP-Server aufsetzen, folgt daraus eine unbequeme Frage. Jeder Server erweitert die Menge dessen, was ein Modell in der eigenen Umgebung tun kann. Diese Erweiterung wirkt in beide Richtungen, sobald jemand anderes das Modell steuert.
Vom Finden zum Ausnutzen
Eine Schwachstelle zu finden ist das eine. Einen funktionierenden Exploit zu bauen, galt lange als der schwierigere Teil. Alonso führte vor, wie weit dieser Abstand geschrumpft ist.
Als Microsoft im April 2026 den Quellcode von MS-DOS offenlegte, war das ein leichter Fall. Das Modell stellte selbst fest, dass es weder Speicherschutz noch ASLR noch DEP gab. Den Exploit lieferte es gleich mit. Der interessantere Fall betrifft moderne Systeme. Dort genügt inzwischen ein CVE-Eintrag, also die knappe öffentliche Meldung einer behobenen Lücke, bewusst ohne Angriffsanleitung. Aus dieser Meldung und dem zugehörigen Commit erzeugten Modelle funktionierende Exploits.
Den Ausschlag gab Claude Mythos, das Anthropic am 7. April 2026 ankündigte und bis heute nicht allgemein freigegeben hat. Anthropics Red Team dokumentierte Exploits, für die erfahrene Penetrationstester nach eigener Einschätzung Wochen gebraucht hätten. In sieben Wochen fand das Modell über 2000 bis dahin unbekannte Schwachstellen, darunter in allen grossen Betriebssystemen und Browsern. Alonso brachte es auf die Formel, die Zeitrechnung habe sich von Stunden auf Minuten verschoben.
Das Patch-Fenster schliesst sich
Daraus ergibt sich das praktische Problem. Es trifft kleine Unternehmen härter als grosse. Ein Exploit entsteht in Minuten. Ein Patch durchläuft Qualitätssicherung, Testumgebung und ein Wartungsfenster, das den laufenden Betrieb nicht stören darf. Alonso formulierte es nüchtern: Die meisten Unternehmen können Systeme weder in 8 noch in 24 Stunden patchen, weil sie nebenbei Dienstleistungen erbringen müssen.
Die Verteidigung war nie darauf ausgelegt, sofort zu reagieren. Sie beruhte auf der Annahme, dass zwischen der Veröffentlichung einer Lücke und ihrer breiten Ausnutzung Zeit liegt. Diese Annahme trug jahrzehntelang. Sie trägt nicht mehr.
Wir sagen nur noch das Ziel
Parallel dazu hat sich die Arbeitsweise mit Modellen verschoben. Noch vor kurzem galt das sorgfältig gebaute Prompt als entscheidende Fähigkeit. Heute beschreibt man laut Alonso einen Problemlöseprozess: Ein Modell zerlegt die Aufgabe, verteilt sie auf Agenten, ein weiterer prüft das Ergebnis und schickt bei Bedarf alles zurück in die Schleife. Vorgegeben wird das Ziel, nicht der Weg.
Sein Einwand dazu kam beiläufig und sass. Wir vergessen dabei zu sagen, was erlaubt ist. Ein Schwarm von Agenten arbeite auf ein Ziel hin. Manche Wege dorthin führten über fremde Systeme oder schlicht über Betrug. Nicht weil die Modelle bösartig wären, sondern weil niemand den zulässigen Lösungsraum abgesteckt hat.
Die Hersteller schreiben es ins Kleingedruckte
Den stärksten Beleg lieferte Alonso nicht mit einem Angriff, sondern mit zwei Screenshots. Der erste zeigt ein Bug-Bounty-Programm, das Jailbreaks und umgangene Sicherheitsfilter ausdrücklich von der Prämie ausnimmt. Die Begründung ist bemerkenswert: Man weiss, dass das Modell dafür anfällig ist, Meldungen bringen also keinen Erkenntnisgewinn.
Der zweite zeigt den Warnhinweis eines agentenfähigen Browsers. Er nennt Prompt Injection beim Namen, warnt vor versteckten Anweisungen in Webseiten und E-Mails und führt als mögliche Folgen Datendiebstahl und Überweisungen an Kriminelle auf. Darunter steht eine Schaltfläche zum Bestätigen. Wer die Technologie nutzen will, klickt.
Alonso zog daraus einen Vergleich mit der Softwareentwicklung früherer Jahrzehnte. Alpha, Beta, Release Candidate. Erst danach ging etwas in Produktion. Heute geht in Produktion, was gerade fertig ist. Bei einer Technologie, deren Schwächen die Hersteller selbst auflisten: Halluzination, Data Poisoning, Prompt Injection, Jailbreaks, Misalignment.
Zur Erinnerung daran, dass es nicht bei technischen Risiken bleibt, verwies er auf Anthropics Threat-Intelligence-Report vom 11. September 2026. Auf knapp 150 Seiten dokumentiert er Missbrauchsfälle über sieben Kategorien, von Cyberoperationen über Überwachung bis zu biologischem Missbrauch. In fünf Fällen nutzten Forschende Claude auf eine Weise, die biologische Waffenentwicklung hätte unterstützen können.
Einordnung
- Die Abstraktionsschicht ist der Hebel. Nicht bessere Modelle haben autonomes Hacken ermöglicht, sondern eine Schicht, die Absichten in Werkzeugaufrufe übersetzt. Wer MCP-Server betreibt, sollte deren Reichweite so eng fassen wie möglich, weil jede zusätzliche Fähigkeit in beide Richtungen wirkt. Worauf beim Verbinden einer WordPress-Seite konkret zu achten ist, steht in unserem Überblick zu den ChatGPT-Plugins.
- Patch-Geschwindigkeit wird zur Überlebensfrage. Wer Wochen braucht, um ein Update einzuspielen, verlässt sich auf ein Zeitfenster, das es nicht mehr gibt. Für KMU heisst das konkret: automatische Updates überall dort, wo sie vertretbar sind. Für den Rest ein realistischer Notfallplan.
- Zielvorgaben brauchen Grenzen. Wenn Agenten nur noch das Ziel erhalten, muss der zulässige Weg dorthin ausdrücklich beschrieben werden. Was nicht eingeschränkt ist, gilt als erlaubt.
- Die Warnhinweise der Anbieter sind Dokumentation. Wer einen agentenfähigen Browser im Unternehmen einsetzt, sollte den Disclaimer lesen wie eine Risikoanalyse, weil er genau das ist.
Einzuordnen bleibt der Rahmen. Alonso sprach über eine Bedrohungslage, für die sein Arbeitgeber Produkte anbietet. Der Schlussteil über Zero Trust, Guardrails und Identitäten für nichtmenschliche Akteure ist entsprechend als Verkaufsargumentation zu verstehen. Die Analyse davor steht unabhängig davon, weil sie sich auf veröffentlichte Forschung und auf Dokumente der Modellanbieter stützt.

Schreibe einen Kommentar